챗GPT 원리, 다음 글자 맞히기로 쉽게 이해하기
챗GPT에게 질문하면 몇 초 만에 긴 답이 술술 나옵니다. 그런데 이 AI는 문장을 미리 다 생각해 두고 쓰는 게 아닙니다. "다음에 올 글자 하나 맞히기"를 아주 빠르게 되풀이할 뿐이에요. 이 글을 끝까지 읽으면 그게 무슨 뜻인지, 그리고 AI가 왜 가끔 그럴듯한 거짓말을 하는지까지 알 수 있습니다.
빈칸 하나 채우기 게임
"옛날 옛적에 ___" 빈칸에 뭐가 올까요? 아마 "어느 마을에"나 "호랑이가"가 먼저 떠오를 겁니다. "냉장고" 같은 말은 거의 안 떠오르죠. 우리 머릿속에서 이미 '이 말이 올 가능성'을 따지고 있다는 뜻입니다.
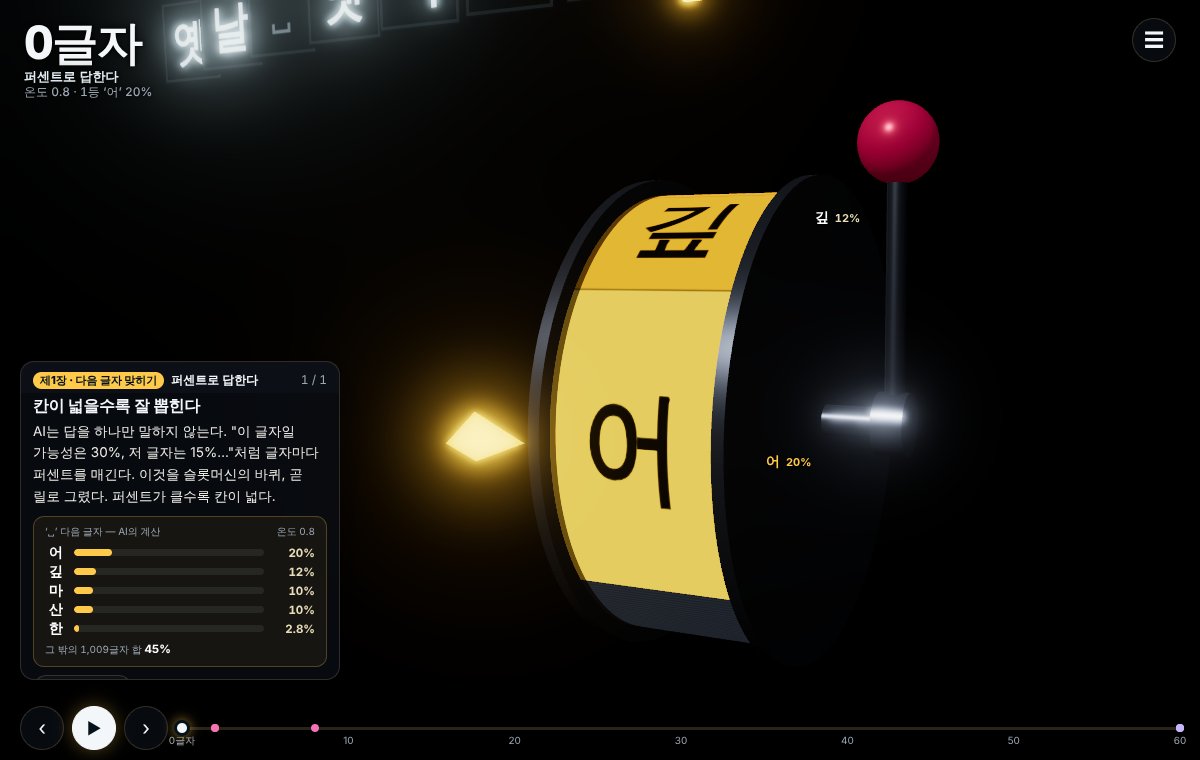
AI도 똑같은 일을 합니다. 다른 점은 답을 하나만 고르지 않고, 후보마다 몇 퍼센트인지 점수를 매긴다는 것입니다. 제가 만든 작은 AI에게 "옛날 옛적에" 다음 글자를 물으면 '어'가 20%, '깊'이 12%, '마'가 10%… 이런 식으로 답합니다. 후보의 퍼센트를 모두 더하면 100%예요. 일기예보의 "비 올 확률 30%"와 같은 뜻의 숫자라고 보면 됩니다. 띄어쓰기와 마침표도 후보 중 하나로 칩니다.
AI는 이 퍼센트를 어떻게 배웠을까
처음 만들어진 AI는 아무것도 모릅니다. 모든 글자에 거의 같은 점수를 주기 때문에, 글을 써 보라고 하면 아무 글자나 뒤죽박죽 나옵니다.
그래서 사람이 쓴 글로 연습을 시킵니다. "옛날 옛적에 어느 산골에 정직한 나무꾼이 살았어요."라는 문장 하나로도 문제를 여러 개 만들 수 있어요. 예를 들어 "…정직한 나무" 다음 글자는? 정답은 "꾼"입니다. 정답이 문장 안에 이미 적혀 있으니 선생님이 따로 채점할 필요도 없죠.
배우기 전의 AI는 이 문제에서 "꾼"에 0.0%를 줬습니다. 후보 가운데 835등이었어요. 그래서 AI 속에 들어 있는 숫자 약 11만 개를 정답 쪽으로 아주 조금씩 고쳤습니다. 이 문제 하나로 8번 고쳤더니 "꾼"의 점수가 51%까지 올라갔습니다. 실제 연습은 문제를 64개씩 묶어서 이 고치기를 2,000번 되풀이했어요.
재미있는 건, 아무도 문법을 가르쳐 주지 않았다는 점입니다. 맞히기 연습만 반복했는데 띄어쓰기를 하고, "~었어요"로 문장을 끝내기 시작합니다.
왜 늘 1등 글자를 고르지 않을까
점수를 다 매겼으면 이제 하나를 골라야 합니다. 1등만 고르면 될 것 같지만, 실제로 해 보면 같은 말을 자꾸 되풀이합니다. 자주 나오는 말 쪽으로만 계속 끌려가거든요.
그래서 AI는 제비뽑기처럼 고릅니다. 30%짜리 글자는 열 번에 세 번쯤 뽑히고, 점수가 낮은 글자도 가끔은 뽑힙니다. seeplore의 「한 글자씩 쓰는 AI」는 이걸 슬롯머신으로 보여 줍니다. 퍼센트가 큰 글자일수록 릴의 칸이 넓어서, 레버를 당기면 넓은 칸에서 멈추는 일이 많아요.
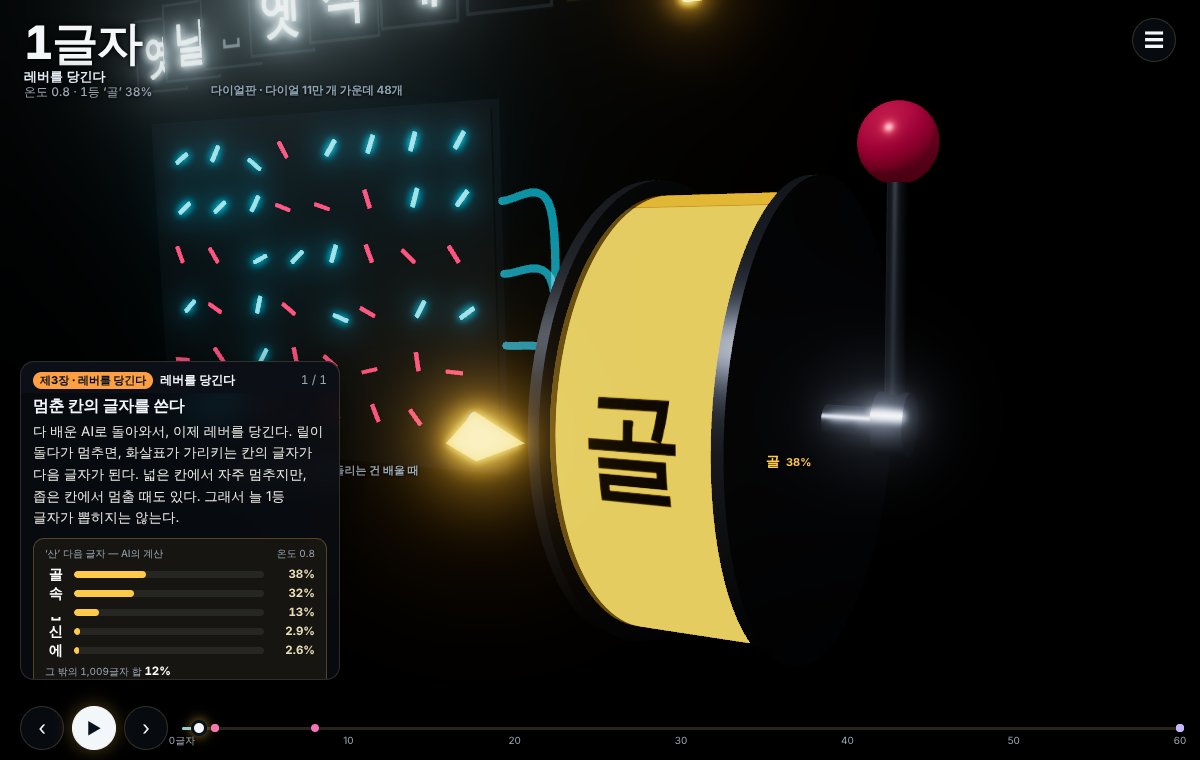
여기에 '온도'라는 설정이 하나 더 있습니다. 온도를 낮추면 1등 글자가 더 잘 뽑혀서 무난하지만 뻔한 글이 되고, 높이면 뜻밖의 글자가 자주 나와서 새롭지만 엉뚱한 글이 됩니다.
뽑힌 글자는 글 끝에 붙고, AI는 한 글자 늘어난 글을 보고 다시 다음 글자를 맞힙니다. 혼자서 끝말잇기를 계속하는 것과 비슷하죠. 같은 질문을 두 번 해도 챗GPT의 대답이 조금씩 다른 이유가 여기 있습니다. 중간에 한 글자만 다르게 뽑혀도 그 뒤가 전부 달라지니까요.
앞 글자에서 단서 찾기
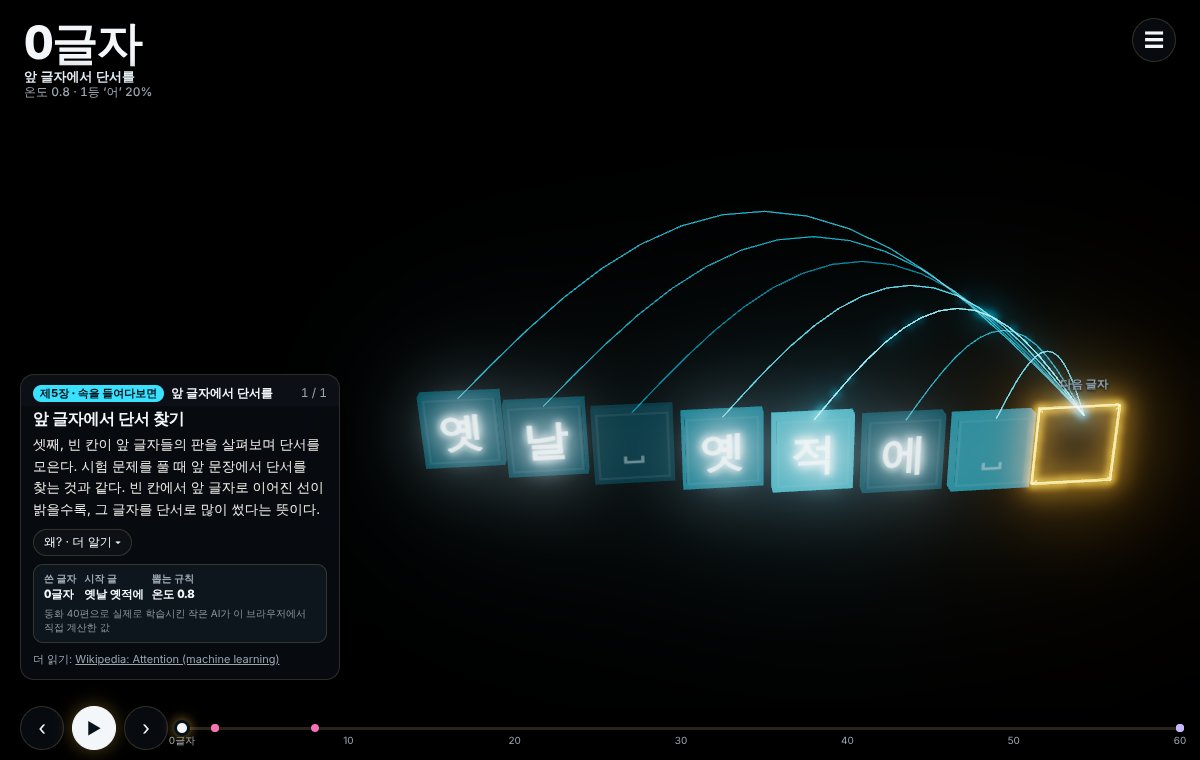
"나무" 다음에는 "꾼"이 잘 오고, "살았어" 다음에는 "요"가 잘 옵니다. 그러니 AI는 앞에 어떤 글자가 있었는지 꼭 봐야 합니다. 시험 문제를 풀 때 앞 문장에서 단서를 찾는 것과 같아요.
아래 그림에서 빈칸(노란 네모)부터 앞 글자들로 이어진 선이 바로 그 모습입니다. 선이 밝을수록 그 글자를 단서로 많이 썼다는 뜻이에요. 이 작은 AI는 앞 64글자까지 볼 수 있습니다. 이렇게 단서를 모으는 장치를 '어텐션'이라고 부르는데, 챗GPT 같은 큰 AI에도 같은 장치가 들어 있습니다.
AI가 그럴듯한 거짓말을 하는 이유
여기까지 읽었다면 AI의 약점도 보입니다. AI는 "그럴듯한 다음 글자"를 고를 뿐, 그 내용이 사실인지는 따지지 않아요.
제가 만든 AI는 동화 40편을 읽고 연습했는데, 이 AI가 쓴 동화는 40편 어디에도 없는 이야기였습니다. 원래 동화와 똑같이 겹치는 부분이 가장 길어 봐야 7글자였어요. 여러 동화의 인물이 한 이야기에 섞여 나오기도 했습니다. 그럴듯하지만 지어낸 이야기인 셈이죠.
챗GPT가 가끔 사실이 아닌 내용을 자신 있게 말하는 것도 같은 이유입니다. 이걸 '환각'이라고 부르는데, 온도를 낮춰도 완전히 사라지지 않습니다. 그래서 숙제나 중요한 정보는 꼭 믿을 만한 곳에서 한 번 더 확인해야 합니다.
작은 AI와 챗GPT, 무엇이 다를까
제가 만든 AI 속에는 점수를 정하는 숫자가 약 11만 개 있고, 읽은 글은 약 8만 5천 자입니다. 2020년에 나온 GPT-3 논문을 보면 GPT-3는 이런 숫자가 약 1,750억 개였고, 약 3,000억 토큰(글자 몇 개씩 묶은 조각)의 글을 읽었습니다. 크기는 비교가 안 되지만 하는 일은 같아요. 앞을 보고, 퍼센트를 매기고, 하나를 뽑아 붙이는 것.
그 뒤에 나온 AI들은 이런 숫자를 대부분 공개하지 않아서 정확한 크기는 알 수 없습니다. 그래도 원리는 이 글에서 본 그대로입니다.
원리를 알고 나면 직접 해 보고 싶어집니다. 「한 글자씩 쓰는 AI」의 '직접 해 보기'에서 시작 글과 온도를 바꿔 가며 레버를 당겨 보세요. AI가 배우는 과정을 더 자세히 보고 싶다면, 손글씨 숫자를 맞히며 틀리고 고치는 모습을 보여 주는 「신호로 보는 AI」도 이어서 볼 만합니다.